
ceph 网络存储(未完)
ceph,存储集群服务系统,相当于,lvm + raid + iscsi + samba + s3对象存储,再加上基于key文件的认证权限系统, 它的rbd块存储运行kvm虚拟机, 可以无中断在不同物理机之间热迁移。所有的文件存储, 块存储, 对象存储, 共享剩余空间。
一般的磁盘阵列, 磁盘出现问题, 需要进行替换操作, ceph存储完全不是这样, 磁盘损坏只会减少总容量, 然后在剩余的空间自动均衡足够的冗余副本。 然后可以按照需要添加硬盘,增加剩余空间就行了。
你可把所有的硬盘都扔给它, 让它在不同的服务器上,给数据保留2份或者3份副本。
几个概念:
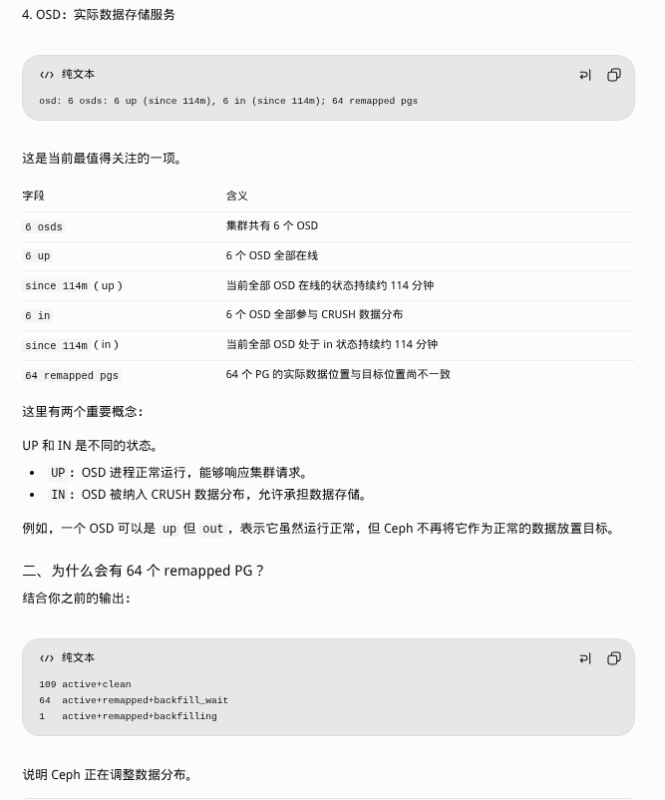
osd 磁盘,一个osd对应一个磁盘或者分区, 相当于vlm的pv,每个osd需要启动一个systemd服务
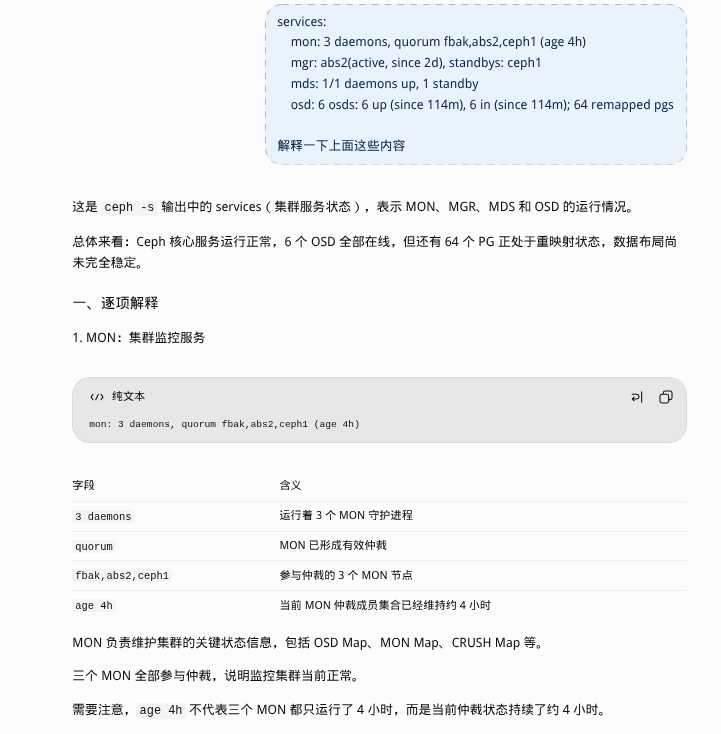
mon 集群状态与仲裁服务 知道哪些数据在哪些osd进行读写, ,
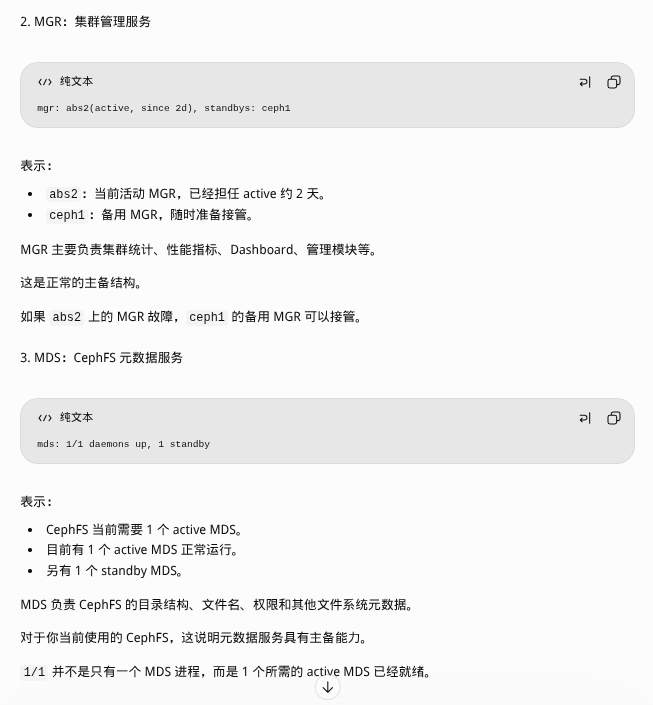
mgr 监控、统计与管理服务
mds 服务 向cephfs客户端提供cephfs文件服务, 集群可信服务器上可以运行多个,每个cephfs客户端一个mds服务
pg (Placement Group,放置组)是 Ceph 用来组织数据、分配副本和执行故障恢复的基本单位。
object (对象) 是 Ceph RADOS 存储系统中实际保存数据的基本单位。 4M一个
pool 存储池 包含多个osd,相当于vlm的vg
rbd 提供的块设备 相当于vlm的lv
cephfs 提供的文件系统 相当于samba
debian13 apt装好ceph后, mgr提示有13个模块不能启动, 是debian13带的python3的bcrypt 跟ceph18不兼容,让全局加载bcrypt 变成按需加载, 就解决了12个模块, 然后剩下的一个模块不重要, 直接禁用就ok了。
虚拟机里的linux和windows2012以上, 对trim支持的很好, 只要用virtio磁盘就可以了,
如果windows2008r2, trim支持的不好, 就需要用这个参数detect-zeroes=unmap, 把0映射为unmap, 然后在windows2008里面, 用这个程序 https://learn.microsoft.com/en-us/sysinternals/downloads/sdelete 在虚拟机执行
sdelete -z c: 对c盘的空闲空间全部写0, 让qemu执行umap
看空间释放情况, 可以用
rbd du pool/diska
rbd sparsify pool/diska
每个osd都对应到一个systemd的服务,要分别添加和启动
systemctl enable --now ceph-osd@2
osd的状态有4种:
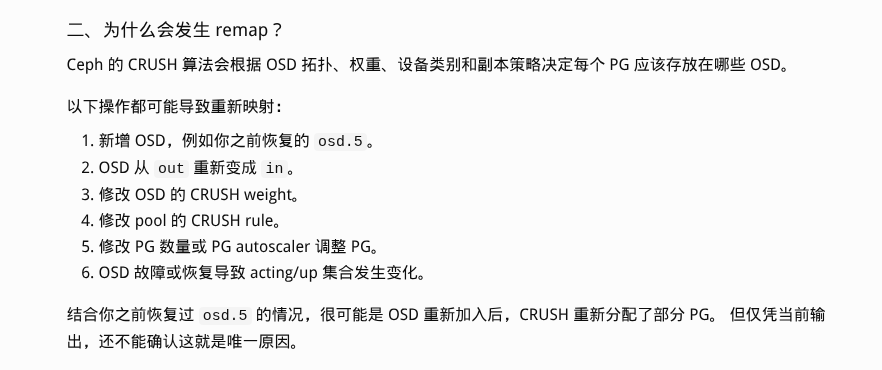
in:OSD 参与 CRUSH 数据分布。
out:OSD 不参与正常数据分布。
up:OSD 进程在线。
down:OSD 进程不在线或无法正常通信。
下面是建立一个osd的步骤, 以 /dev/sdx, lvm底层为例, 它会把sdx建立成pv, 做成vg,然后全部分为一个lv, 在lv上建立osd, 如果不想用lvm ,可以把lvm换成raw
/dev/sdx 数据即将被清理,如果有必要,先要做备份。
下面是移除一个osd的步骤, 以osd.5为例
1:ceph osd tree 看每个osd在哪个机器上。
2:ceph osd out 5 把osd.5暂时下线。
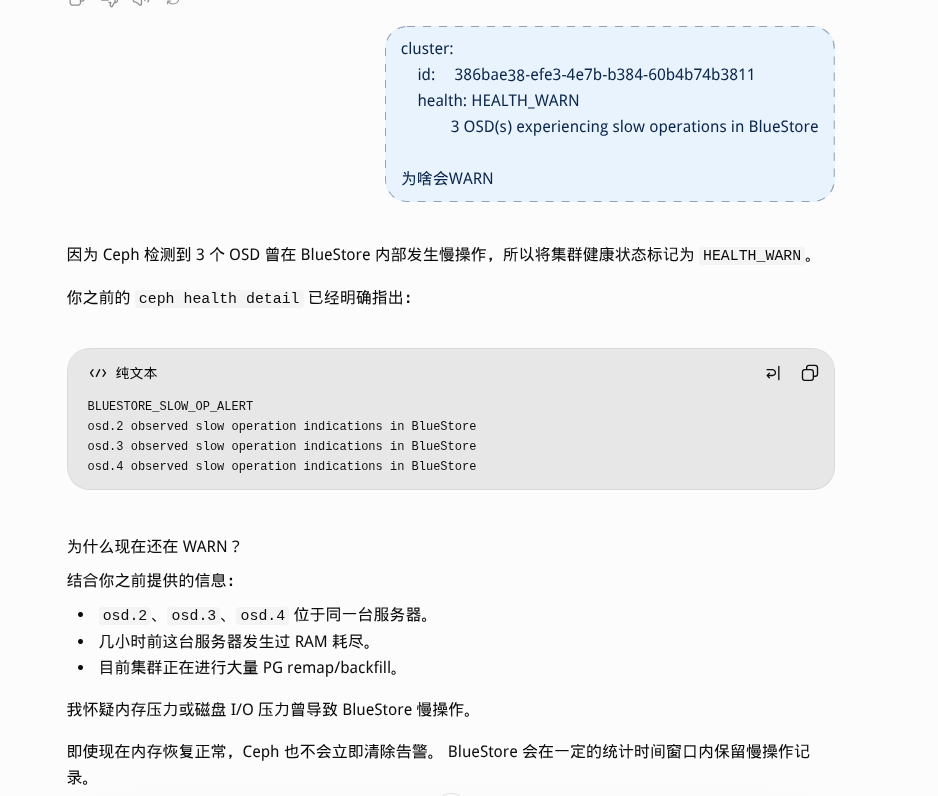
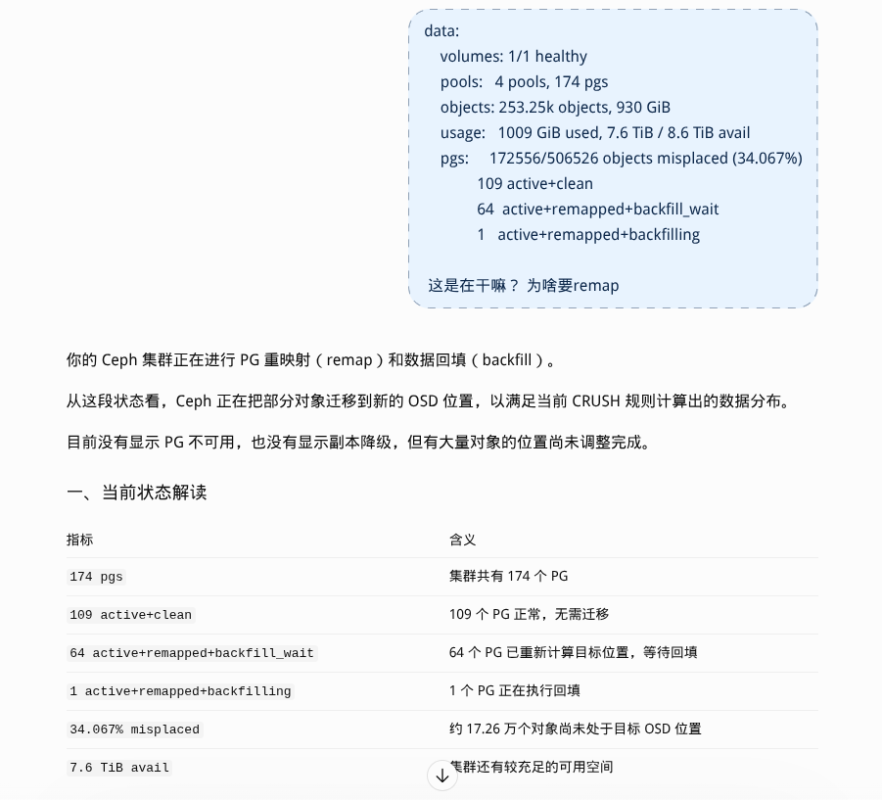
3:ceph osd safe-to-destroy 5 先检查是否可以安全移除, 如果pg正在修复或者正在迁移, 最好等它完成,ceph -s 可以看到还有多少object需要迁移, 已经每秒迁移多少个object, 如果pool的冗余都大于2, 并且没有降配的,那么即使没有迁移完成, 也可以直接移除osd.5 因为这些迁移, 大概率是在迁移osd.5,
4:systemctl disable --now ceph-osd@5 关闭osd.5服务 systemctl需要在osd.5所在的服务器执行
5:ceph osd purge 5 --yes-i-really-mean-it 这个命令真正把osd.5移除,至此,ceph osd tree 看不到osd.5了
6:osd.5的/dev/sdx如果是lvm设备, 就这样清理:ceph-volume lvm zap /dev/sdx --destroy, 如果是裸设备, 直接 wipefs -a /dev/sdx 就可以了, 如果是lvm也可以使用lvm的工具,去做lv, vg,pv管理, ceph 封装为一条命令来完成了。 有时候AHDI会把裸设备识别出一些虚假的分区,dmesg里能看到提示 ( sdx: AHDI sdx1 sdx3), 此时只要用dd, 对sdx的第一个扇区写0就行了,然后partprobe这些虚假的AHDI分区就没了
osd分成pg, pg组成pool , pool里的n个冗余, 根据规则, 可以要求在不同的服务器。上,
pool建立:
ceph osd pool create rbd_pool
设置pool使用3个冗余副本
ceph osd pool set rbd_poo size 3
最小2个冗余副本, 低于2个冗余副本时, pool会只读
ceph osd pool set rbd_poo min_size 2
rbd建立
如果第一次在pool建立rbd 需要先初始化:
ceph osd pool application enable rbd_pool rbd
rbd pool init rbd_pool
然后建立rbd
rbd create rbd_pool/diska --size 100G
rbd快照: rbd snap create rbd_pool/diska@diska-20261026
使用rbd
qemu直接支持ceph , 可以直接使用rbd qemu命令行:
-drive file=rbd:rbd_pool/u8,format=raw,discard=unmap,detect-zeroes=unmap,if=virtio,index=0
在linux下, 需要把rbd 映射为 /dev/rbd0
rb map rbd_pool/diska
取消/dev/rbd0
rbd unmap /dev/rbd0
建立cephfs
首先需要在提供cephfs的服务器上建立mds服务
需要建立2个pool, 每个cephfs需要2个pool ,分别存放metadata 和 data
ceph osd pool create cephfs_metadata 64 64
ceph osd pool create cephfs_data 128 128
建立cephfs myiso
ceph fs new myiso cephfs_metadata cephfs_data
ceph fs ls 列出cephfs
建立一个独立的key,用来访问myiso
ceph auth get-or-create client.myiso mon 'allow r' mds 'allow rw' osd 'allow rw pool=myiso_data' -o ceph.client.myiso.keyring
cephfs默认df看到的是所有的cephfs占用, 和所有的cephfs空间, 可以用admin账号临时挂载到/mnt, 然后修改限额,有时候, 挂载的用户权限可能不全, 所以要用高权限也用户临时挂载, 权限用ceph auth get client.user看, mds行要="allow *":
setfattr 包含在软件包attr里, apt install attr
info migrate 看迁移过程, 看到Migration status: completed 后,在源qemu的命令行quit退出qemu就行了
| 附件 | 大小 |
|---|---|
| warn.png | 111.55 千字节 |
| warn1.png | 34.27 千字节 |
| remap.png | 173.84 千字节 |
| remap1.png | 71.13 千字节 |
| service.png | 92.63 千字节 |
| mgr_mds.png | 73.49 千字节 |
| osd.png | 122.52 千字节 |
- 刘世伟's blog
- 要发表评论,请先登录